





Recherchez les définitions qui vous manquent !
Sur Shopify, le tracking obéit à des règles que les autres plateformes n’ont pas : le tunnel de commande est un environnement isolé depuis 2024, les fichiers de thème n’y sont plus éditables, et les cookies n’y sont plus joints automatiquement aux requêtes. Les applications natives du App Store permettent de démarrer, mais elles collectent côté navigateur et coûtent 20 à 25 % du volume de données.
Cette formation déroule l’architecture que nous déployons chez nos clients Shopify, les trois conditions sans lesquelles elle ne vaut pas mieux qu’une application native, et les résultats que nous mesurons. Elle s’appuie sur le webinaire présenté par William Voyer, Web Analyst chez Boryl, qui a passé l’année sur des implémentations et des migrations Shopify.
La version vidéo, 1 heure :
Pourquoi le tracking Shopify est-il un cas particulier ?
Qu’est-ce que le checkout extensibility ?
Le checkout extensibility est la refonte du tunnel de commande de Shopify, apparue en 2022 et rendue obligatoire pour toutes les boutiques en 2024. Shopify a voulu uniformiser le parcours d’achat entre tous les marchands, pour deux raisons : fluidifier l’expérience, et renforcer la sécurité en fermant l’accès au code du tunnel.
Du point de vue d’un marchand, le changement est simple à résumer : le checkout est devenu un environnement isolé, un bac à sable sur lequel personne n’a la main.
Pour la mesure, c’est une petite révolution, et elle est encore mal digérée par beaucoup d’équipes. Regardons précisément ce qui change, et ce qui ne change pas.
Ce qui ne change pas : tout ce qui se passe hors du tunnel
Sur les pages de catalogue, les fiches produit, le panier, rien n’a bougé. Les fichiers de thème au format `.liquid` restent accessibles et modifiables.
Nous pouvons donc y faire ce que nous ferions sur n’importe quel site : alimenter une couche de données, ou dataLayer, avec les événements qui nous intéressent. Vue de liste produit, vue de fiche, ajout au panier, clic sur un filtre, tout est possible.
Si la notion de couche de données ne vous est pas familière, notre formation Google Tag Manager la détaille, et notre guide du plan de taggage explique comment la concevoir avant de l’implémenter.
Ce qui change : tout ce qui se passe dans le tunnel
Dès que le visiteur entre dans le checkout, les règles changent d’un coup.
– Le fichier `checkout.liquid` n’existe plus. Il était éditable pour les comptes Shopify Plus, il ne l’est plus pour personne.
– La couche de données classique n’y vit plus. Le code du thème ne s’exécute pas dans cet environnement isolé.
– Les événements `begin_checkout`, `add_payment_info` et `purchase` ne peuvent plus être posés à la main.
Le seul chemin restant s’appelle le custom pixel. C’est un espace dédié, accessible depuis l’administration Shopify, dans lequel nous déclarons ce que nous voulons écouter. Shopify nous fournit en retour les événements par son API.
Et il faut reconnaître que cette API est le bon côté de l’histoire. Elle expose les événements e-commerce standards, le contenu du panier, les informations de transaction, de façon fiable et documentée. Nous n’avons plus à construire nos propres conditions de déclenchement : c’est l’API qui déclare qu’un achat a eu lieu, et elle le fait mieux qu’une règle maison qui surveille une URL de confirmation.
Le piège des cookies dans le tunnel de commande
Voici le point qui casse silencieusement l’attribution de nombreuses boutiques, et que nous rencontrons sur la majorité de nos migrations. Prenons le temps de le comprendre, parce qu’il est contre-intuitif.
Sur un site classique, les cookies déposés sur votre domaine sont automatiquement attachés aux requêtes que le navigateur envoie. L’identifiant de clic de Google, le `gclid`, et celui de Meta, le `fbclid`, partent avec l’événement sans que personne ait à s’en occuper. C’est le fonctionnement normal du web.
Dans le checkout de Shopify, ce n’est plus vrai. Les cookies sont toujours déposés, ils restent parfaitement lisibles, mais ils ne sont plus joints automatiquement aux requêtes sortantes.
Le résultat mérite qu’on s’y arrête : vous collectez bien l’achat, vous l’envoyez bien à Google Ads, et il arrive sans identifiant de clic. La conversion existe, elle est comptée, elle n’est rattachée à aucune campagne.
Remarquez la difficulté. Le volume total de conversions reste correct. Votre chiffre d’affaires dans Google Analytics 4 est juste. C’est la répartition par canal qui devient fausse : le trafic payant semble ne rien rapporter, et le trafic direct semble extraordinaire. Personne ne cherche un bug dans un chiffre qui a l’air normal.
La correction consiste à lire la valeur du cookie côté client, puis à la transmettre explicitement comme un paramètre d’événement, exactement comme nous transmettons un identifiant de transaction. Si vous ne retenez qu’un point technique de cette formation, retenez celui-là.
Que valent vraiment les applications natives du Shopify App Store ?
Comment fonctionnent-elles ?
Le Shopify App Store propose un catalogue dense d’applications qui connectent votre boutique aux outils du marché, sans écrire une ligne de code.
Vous y trouverez la plupart des régies publicitaires, Meta, Google, TikTok, Pinterest. Des outils analytics, Google Analytics, Matomo, Piwik Pro. Et des outils de relation client, Klaviyo et Brevo en tête, qui équipent l’essentiel des boutiques françaises.
Le principe est toujours le même : vous installez, vous connectez votre compte, et l’application se charge d’envoyer les événements standards vers l’outil.
Leurs deux vrais avantages
Soyons justes avant d’être critiques, parce que ces applications rendent un vrai service.
Le premier avantage est l’absence totale de compétence technique requise. Une boutique qui se lance peut avoir un tracking correct en une demi-journée, sans développeur et sans agence. Les achats, les ajouts au panier et les vues produit remontent dans Meta et dans Google Ads. Pour valider un marché, c’est amplement suffisant.
Le second avantage est moins connu, et il est décisif : la synchronisation du catalogue produit. L’application native pousse votre catalogue vers le gestionnaire de publicité, avec les images, les prix, les stocks. C’est ce qui rend possible le remarketing dynamique, celui qui montre à un visiteur le produit exact qu’il a regardé.
Ce second point est si important que nous recommandons de conserver les applications natives même après avoir déployé une configuration personnalisée. Nous y reviendrons.
Limite 1 : aucune personnalisation possible
Ces applications sont conçues pour fonctionner sur toutes les boutiques du monde. Elles envoient donc ce que toutes les boutiques ont en commun : la vue produit, l’ajout au panier, l’achat.
Que se passe-t-il si votre activité a des particularités ? Et c’est presque toujours le cas.
– Vous vendez des abonnements et voulez distinguer un premier abonnement d’un achat unique.
– Vous proposez des coffrets, dont la valeur ne se calcule pas comme celle d’un produit simple.
– Vous voulez envoyer un événement d’achat spécifique aux nouveaux clients.
Dans les trois cas, l’application ne saura pas le faire. Elle décide à votre place de ce qui part, et vous n’avez aucun levier pour l’infléchir.
Limite 2 : la collecte se fait côté navigateur
C’est la limite la plus coûteuse, et la moins visible.
La majorité des événements transmis par ces applications partent depuis le navigateur du visiteur, vers des adresses que les bloqueurs de publicité connaissent par cœur. Résultat : environ 20 à 25 % du volume de collecte est perdu.
S’y ajoute la question de la durée de vie des cookies, sur laquelle vous n’avez aucune prise depuis une application native. Nous y consacrons tout un prérequis plus bas.
Un détail rend ce problème encore plus pernicieux : le niveau de protection varie d’une application à l’autre. L’application Meta alimente l’API de conversion, donc elle résiste bien. Pinterest et Klaviyo restent essentiellement côté navigateur, donc elles résistent mal. Vous gérez votre mesure à travers une mosaïque d’outils sans savoir lequel tient et lequel cède.
Limite 3 : les incohérences que vous ne pouvez pas corriger
Nous avons observé chez plusieurs clients des chutes brutales de collecte : plus aucune donnée ne remontait dans Meta à partir d’une certaine date, sans explication apparente.
La cause était un bug de l’intégration native. Et c’est là que le mode « pilote automatique » montre sa limite : vous n’avez pas la main. Vous ne pouvez ni diagnostiquer, ni corriger. Vous attendez que l’éditeur s’en aperçoive et publie un correctif.
Pendant ce temps, vos campagnes apprennent sur des données incomplètes.
Limite 4 : le problème de gouvernance
Additionnons les trois limites précédentes et regardons le résultat.
Votre tracking est réparti entre six ou sept applications, chacune avec ses propres réglages, son propre niveau de résilience, son propre calendrier de mise à jour. Personne dans l’entreprise ne peut répondre à la question « qu’est-ce qui part, vers qui, et dans quel état ? ».
En centralisant tout dans Google Tag Manager, cette question redevient simple. Vous savez ce qui passe par le serveur, ce qui n’y passe pas, et vous pouvez modifier n’importe quel comportement sans toucher au site ni attendre un éditeur.
Si votre collecte part aujourd’hui dans plusieurs directions sans que personne n’en tienne la carte, un audit de la collecte existante est le préalable à toute refonte. Notre formation sur l’audit de tracking détaille la méthode si vous voulez la mener vous-même.
À quoi ressemble une architecture de tracking Shopify optimale ?
Les trois étages de l’architecture
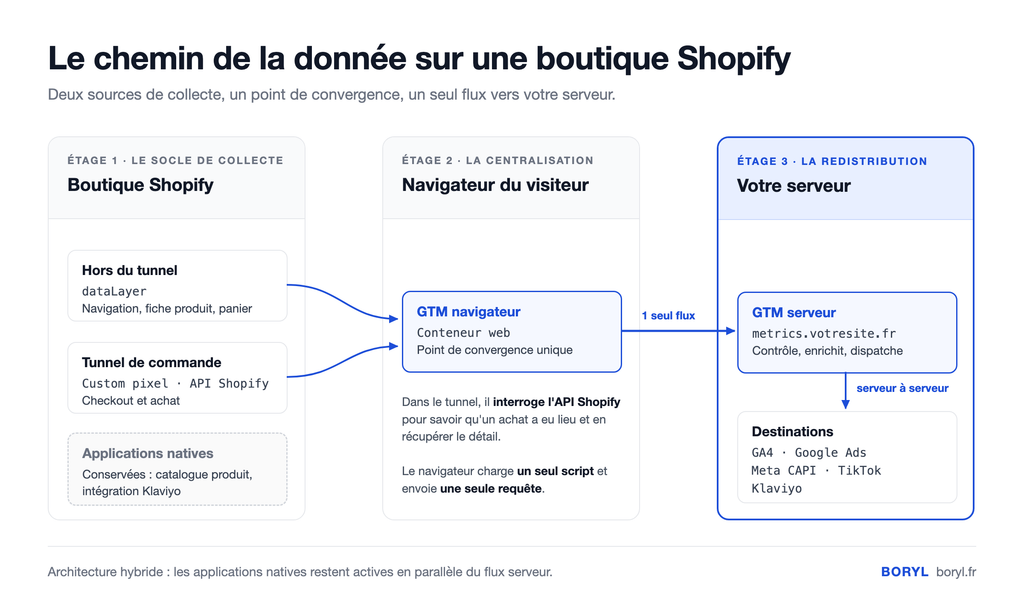
L’architecture que nous déployons s’organise en trois étages. Prenons-les dans l’ordre où la donnée les traverse.
Étage 1, le socle de collecte. La boutique Shopify émet ses informations à deux endroits distincts : dans la couche de données pour tout ce qui se passe hors du tunnel, et dans l’API Shopify pour tout ce qui s’y passe. Les applications natives, elles, restent en place et continuent de fonctionner.
Étage 2, la centralisation. Un conteneur Google Tag Manager, celui qui s’exécute dans le navigateur, récupère ces informations des deux sources. Dans le tunnel, il interroge l’API pour savoir qu’un achat a eu lieu et en récupérer le détail. Tout converge vers ce point unique.
Étage 3, la redistribution. Le conteneur navigateur envoie un flux unique vers un conteneur Google Tag Manager server-side, qui se charge ensuite de dispatcher vers Google Analytics 4, Google Ads, Meta, TikTok et Klaviyo, en connexion de serveur à serveur.
Un bénéfice rarement mentionné : le site s’allège
Cette architecture a un effet secondaire que personne ne met en avant, et qui plaît beaucoup aux équipes techniques.
Prenons un ajout au panier sur une boutique équipée de six outils. Dans une configuration classique, le navigateur charge et exécute six scripts, un par destination, et envoie six requêtes.
Avec l’architecture ci-dessus, il charge un seul script, celui du transporteur, et envoie une seule requête vers votre serveur. Le serveur se charge du reste, hors du navigateur du visiteur.
Le nombre de ressources chargées sur le site est divisé par cinq ou six. Les temps de chargement s’améliorent, et avec eux les Core Web Vitals.
Qu’est-ce que le tracking hybride ?
Le tracking hybride consiste à conserver la collecte navigateur en parallèle de la collecte serveur, plutôt que de la remplacer. C’est l’architecture que nous déployons chez la quasi-totalité de nos clients, et elle surprend souvent.
Pourquoi garder les deux ? Parce qu’elles ne tombent pas dans les mêmes conditions. Le navigateur est bloqué par les extensions, le serveur ne l’est pas. Le navigateur capte des signaux que le serveur n’a pas, le serveur transmet ce que le navigateur perd.
En additionnant les deux, nous maximisons la collecte au lieu de choisir.
Pourquoi le double envoi n’est-il pas un défaut ?
Voici le point le plus souvent mal interprété, y compris par des équipes techniques.
Prenons Meta. En tracking hybride, nous collectons l’achat côté navigateur et nous l’envoyons au pixel, comme dans une configuration classique. Cette requête sera peut-être bloquée par une extension. Ce n’est pas grave.
Car en parallèle, le même événement part vers notre serveur, qui le transmet à l’API de conversion de Meta en serveur à serveur. Celui-là, rien ne peut l’intercepter.
Les deux envois portent un identifiant de déduplication. Meta rapproche les deux, comprend qu’il s’agit du même achat, et ne le compte qu’une seule fois.
Donc : voir deux appels vers Meta pour un même achat n’est pas un bug de configuration. C’est la configuration correcte, et c’est celle que Meta recommande. Ce qui serait un défaut, c’est un appel direct sans identifiant de déduplication.
Le raisonnement vaut pour TikTok, Pinterest et Snapchat, qui ont chacun leur mécanisme équivalent.
Faut-il supprimer les applications natives ?
Non, et c’est le conseil qui surprend le plus nos clients.
Rappelez-vous le second avantage que nous évoquions plus haut : la synchronisation du catalogue produit. Aucune architecture server-side ne remplit ce rôle. Supprimer l’application native pour faire propre, c’est perdre le catalogue pour gagner en élégance.
Nous allons même plus loin sur certains outils. Sur Klaviyo, nous conservons l’intégration native et nous posons la nôtre en parallèle. Deux sources de collecte valent mieux qu’une quand l’objectif est de capter le maximum de données.
L’architecture visée est hybride, à tous les étages. Elle n’est pas pure, et c’est volontaire.
Addingwell et Stape, le socle que nous utilisons
Ces deux fournisseurs hébergent des conteneurs Google Tag Manager serveur, et ils proposent tous les deux une application sur le Shopify App Store. C’est ce qui change tout sur cette plateforme.
Leur application fait quatre choses en quelques clics :
– elle installe le conteneur sur la boutique
– elle le proxyfie, c’est-à-dire qu’elle masque les chemins reconnaissables
– elle étend la durée de vie des cookies
– et surtout, elle pousse automatiquement dans la couche de données l’ensemble des événements e-commerce standards, y compris ceux du tunnel de commande
Ce dernier point mérite d’être mesuré : vous obtenez la vue de catégorie, la vue produit, l’ajout au panier, l’affichage du panier, l’entrée dans le tunnel, jusqu’à l’achat. Sans écrire de code.
Nous partons systématiquement de ce socle, même sur les configurations les plus avancées. Reconstruire à la main ce que ces applications font en quelques clics est du temps perdu, et du temps facturé au client pour rien.
Le custom vient ensuite, pour les événements propres à votre activité : l’abonnement à distinguer, le coffret à valoriser, la marge à réconcilier côté serveur.
Quels sont les trois prérequis d’une configuration qui surperforme les applications natives ?
Nous arrivons au cœur du sujet. Une configuration server-side mal finie n’est pas meilleure qu’une application native : elle est seulement plus chère.
Trois prérequis la séparent d’une installation qui tient ses promesses. Aucun n’est optionnel.
Prérequis 1 : maximiser la collecte
L’objectif est que la donnée parte, malgré les bloqueurs. Quatre éléments doivent être proxyfiés, et oublier le dernier annule souvent les trois premiers.
Proxyfier le chargement du conteneur
Le script standard de Google Tag Manager charge votre conteneur depuis une adresse qui contient `googletagmanager.com`.
Ce motif est identifié par les listes de filtrage et coupé systématiquement. Et la conséquence est brutale : si le conteneur ne se charge pas, plus rien n’est collecté, y compris ce qui aurait dû partir vers votre serveur. Vous perdez tout, pas une partie.
Proxyfier la librairie gtag
Si vous utilisez un transporteur Google Analytics 4, ce qui est le cas dans environ 95 % des configurations, la librairie `gtag` doit elle aussi être servie depuis un chemin masqué.
Sans cela, elle est bloquée, et la collecte s’arrête au même endroit qu’au point précédent.
Proxyfier le flux vers le serveur
Nous sommes en configuration server-side, donc un flux part du conteneur navigateur vers le conteneur serveur. Il faut éviter qu’il soit intercepté lui aussi.
Changer le domaine de destination vers votre sous-domaine est nécessaire, mais ce n’est pas suffisant. Le premier segment du chemin doit également être modifié, pour retirer le motif `/g/collect` que les listes reconnaissent, et le remplacer par une valeur quelconque.
C’est une confusion fréquente : beaucoup d’équipes changent le domaine, constatent que ça ne suffit pas, et concluent que la proxyfication ne marche pas.
Proxyfier la plateforme de consentement
Ce quatrième point est facultatif sur le papier, et il est presque toujours négligé. Voici pourquoi nous le traitons quand même.
Les bloqueurs les plus avancés ne se contentent pas de couper les requêtes de mesure. Ils identifient les bannières de consentement et les masquent.
Déroulons la conséquence. La bannière ne s’affiche jamais. Le visiteur ne peut donc jamais accepter. Aucun consentement n’est enregistré. Et par conséquent, aucune donnée ne part, quelle que soit la qualité de votre infrastructure serveur.
Une installation parfaite peut ainsi être entièrement neutralisée par une bannière bloquée. Toutes les plateformes de consentement ne permettent pas cette proxyfication, mais un certain nombre le proposent.
Prérequis 2 : maximiser la reconnaissance de l’utilisateur dans le temps
Pourquoi les cookies meurent-ils si vite ?
Un cookie peut légalement vivre treize mois. C’est la durée autorisée par le RGPD et rappelée par la CNIL.
Mais plusieurs navigateurs appliquent leurs propres règles, plus strictes. Safari, Firefox et Brave ramènent la durée de vie des cookies analytiques et publicitaires à 7 jours, et descendent à 24 heures lorsque l’URL d’arrivée contient des paramètres de campagne, ce qui est le cas de tout clic publicitaire.
Prenons un exemple concret. Un visiteur clique sur votre publicité Instagram depuis son iPhone. Il regarde, il ne commande pas. Il revient deux jours plus tard et achète.
Sur Safari, son cookie a expiré au bout de 24 heures. Meta ne peut pas relier cet achat à la publicité qui l’a fait venir. Vous payez une campagne dont vous ne verrez jamais le résultat.
Qu’est-ce que le cookie _shopify_y ?
Et c’est ici que Shopify nous rend un service que les autres plateformes ne rendent pas.
Shopify dépose nativement, sur toutes les boutiques, un cookie nommé `_shopify_y`. Sa durée de vie est de treize mois, et il n’est pas soumis aux restrictions qui frappent les cookies analytiques et publicitaires.
Autrement dit, vous disposez d’un identifiant stable et durable, gratuitement, sur chaque boutique Shopify.
Comment fonctionne la restauration de cookies ?
Addingwell comme Stape savent utiliser ce cookie comme clé de réconciliation. Le principe tient en trois temps.
1. À la première visite, nous stockons en base de données tous les cookies analytiques et publicitaires du visiteur, indexés par la valeur de `_shopify_y`.
2. Le visiteur revient sept jours plus tard. Ses cookies Google et Meta ont été supprimés par Safari. Mais `_shopify_y`, lui, est toujours là.
3. Nous l’interrogeons, nous retrouvons les cookies stockés, et nous les redéposons.
Le visiteur redevient la même personne aux yeux de vos outils. La durée de vie effective de l’ensemble de vos identifiants passe ainsi à environ treize mois.
C’est le mécanisme qui a le plus d’effet sur l’attribution, et il est propre à Shopify.
Pourquoi pas le reverse proxy sur Shopify ?
Il existe une autre méthode pour contourner les restrictions des navigateurs : le reverse proxy, qui consiste à faire correspondre les adresses IP du serveur de collecte et du site.
Elle fonctionne très bien, et nous l’utilisons ailleurs. Sur Shopify, nous ne la mettons pas en place : le cookie natif rend le détour inutile et beaucoup plus simple à maintenir.
Retenez donc que le reverse proxy reste pertinent pour les sites qui ne sont pas sur Shopify.
Prérequis 3 : maximiser l’identification personnelle
Reconnaître un visiteur ne passe pas que par les cookies
Les cookies identifient un navigateur. Les données personnelles, adresse email en tête, identifient une personne, et elles franchissent les appareils.
C’est le second pilier de l’identification, pour les algorithmes publicitaires comme pour vos scénarios de relation client.
Ce que Shopify récupère par défaut, et ce qu’il manque
Avec une intégration native seule, Shopify ne transmet les données personnelles qu’au moment où le visiteur se connecte à un compte client. C’est logique : c’est là qu’il connaît son identité.
Mais réfléchissons à tous les autres moments où un visiteur vous donne son adresse :
– un formulaire personnalisé, du type Typeform, posé sur une page
– une inscription à un jeu concours
– une demande de devis ou de contact
– un formulaire de retour en stock
Dans tous ces cas, l’intégration native ne transmet rien. La personne vous a donné son adresse, et votre outil de relation client ne le saura jamais.
Ce que nous ajoutons
Nous traquons ces formulaires en JavaScript depuis Google Tag Manager. Nous récupérons la soumission et l’adresse email, et nous les transmettons à Klaviyo comme à Meta.
Nous allons un cran plus loin : une fois le visiteur identifié, ses données personnelles sont déposées dans un cookie posé par le serveur, qui persiste dans le temps. À sa visite suivante, même s’il n’est pas connecté, un simple ajout au panier peut être rattaché à son identité.
C’est ce mécanisme qui produit le gain d’identification que nous mesurons plus bas.
Comment gérer le consentement sur Shopify ?
Qu’est-ce que la Customer Privacy API ?
La Customer Privacy API est le mécanisme par lequel Shopify centralise le consentement des visiteurs. C’est elle qui autorise, ou non, les applications natives à recevoir des données.
Depuis le checkout extensibility, son rôle est devenu obligatoire : sans elle, Shopify ne sait pas ce que le visiteur a accepté, et les applications ne peuvent pas adapter leur comportement.
Le problème que nous rencontrons systématiquement
Voici le scénario que nous voyons sur la majorité des boutiques que nous auditons.
Une plateforme de gestion du consentement a été installée. La bannière s’affiche correctement. Le visiteur accepte ou refuse. Tout semble en ordre.
Mais le choix n’est jamais transmis à la Customer Privacy API.
Les conséquences dépendent de votre configuration, et elles sont mauvaises dans les deux cas. Soit les applications natives cessent de recevoir des données, parce qu’elles considèrent qu’aucun consentement n’a été donné, et vous perdez de la collecte sans le savoir. Soit elles continuent de collecter sans condition, et vous êtes en infraction.
Dans les deux cas, rien ne vous alerte.
Comment transmettre le consentement ?
Certaines plateformes de consentement se configurent directement dans Shopify et transmettent le statut automatiquement. C’est le cas le plus confortable, vérifiez d’abord si la vôtre le propose.
Pour les autres, la transmission se pose à la main, généralement depuis Google Tag Manager, avec un appel de cette forme :
« `js
window.Shopify.customerPrivacy.setTrackingConsent({
analytics: true, // mesure d’audience
marketing: true, // publicité et remarketing
preferences: true // confort de navigation
}, function() {
// rappel exécuté une fois le consentement enregistré
});
« `
Les valeurs doivent évidemment refléter le choix réel du visiteur, pas être fixées à `true` comme dans cet exemple pédagogique.
Comment vérifier que ça fonctionne ?
Ouvrez la console de votre navigateur sur la boutique, faites un choix sur la bannière, puis tapez :
« `js
window.Shopify.customerPrivacy.currentVisitorConsent()
« `
Le retour doit correspondre exactement à ce que vous venez de choisir. S’il ne bouge pas quand vous changez d’avis, la transmission n’est pas en place.
Les deux régies à traiter séparément
Google attend en plus un Consent Mode correctement câblé, dans sa version 2, avec ses quatre signaux distincts.
Meta fonctionne en consentement strict et binaire : sans signal marketing accepté, rien ne doit partir. Il n’y a pas de demi-mesure ni de modélisation possible.
Quels résultats pouvons-nous attendre ?
Nous mesurons trois choses à la fin de chaque implémentation. Les chiffres qui suivent sont des moyennes observées chez nos clients Shopify.
La fiabilité : est-ce que la donnée est juste ?
C’est la première question, et c’est celle que presque personne ne se pose.
Nous comparons le chiffre d’affaires remonté dans l’outil analytics à celui du back-office Shopify, sur un mois complet. Nous obtenons en moyenne 93 % de fiabilité.
Nous faisons la même comparaison sur les achats envoyés à l’API de conversion de Meta, rapportés aux commandes réelles : 95 %. Et sur les soumissions de formulaires, comparées aux entrées réellement créées : 97 %.
Une précision honnête : atteindre 100 % est impossible, et se faire promettre le contraire est un signal d’alerte. Il y aura toujours des commandes passées par téléphone, des remboursements traités à part, des visiteurs qui bloquent absolument tout.
Mesurez ce taux à la fin de chaque chantier. C’est le seul indicateur qui dise si l’intervention a servi à quelque chose.
Le volume : combien de données gagnons-nous ?
Nous comparons le volume d’événements envoyés à l’API de conversion de Meta, avant et après le passage au serveur.
Le gain moyen est de 22 % de conversions supplémentaires. Ce sont 22 % de signaux en plus pour les algorithmes, et 22 % de conversions en plus attribuées à vos campagnes.
La performance : qu’est-ce que ça rapporte ?
Le gain de performance publicitaire pur est très difficile à isoler, et nous nous méfions des agences qui l’affirment sans réserve. Trop de variables bougent en même temps.
Nous avons donc mesuré là où la population est identifiable : les scénarios de relation client.
Sur un scénario d’abandon de panier, nous avons construit une population d’utilisateurs qu’il était impossible de capter sans conteneur serveur. Ces visiteurs entrent dans le scénario grâce à lui, et nous pouvons mesurer le chiffre d’affaires qu’ils génèrent : +40 %.
Et grâce au travail sur les données personnelles décrit plus haut, le taux d’identification des visiteurs progresse de 19 %.
Où en est le marché français ?
Pour situer votre boutique, nous avons analysé en septembre 2026 les 394 boutiques Shopify présentes dans le palier des 10 000 sites les plus visités en France.
– 111 d’entre elles, soit 28 %, ont un conteneur servi depuis leur propre domaine. C’est le taux le plus bas des trois grandes plateformes e-commerce, derrière PrestaShop à 32 % et Magento à 39 %.
– Mais 23 % de ces boutiques équipées posent un vrai cookie serveur, contre 5 % sur PrestaShop et 6 % sur Magento. Shopify est donc la plateforme la moins équipée, et la mieux équipée.
– L’explication tient au sujet que nous traitions plus haut : les applications du App Store font le travail que les déploiements maison négligent.
– Klaviyo équipe 73 % des boutiques Shopify du panel, et la grande majorité l’alimente encore entièrement côté navigateur.
Ce dernier chiffre mérite votre attention si vous êtes dans ce cas : c’est probablement votre gisement le plus immédiat.
Comment se lancer ?
Résumons la marche à suivre, dans l’ordre.
1. Auditez l’existant avant de toucher à quoi que ce soit. Quelles applications natives sont installées, que collectent-elles, le consentement est-il transmis à la Customer Privacy API.
2. Posez le socle, avec l’application Addingwell ou Stape, qui vous donne les événements e-commerce standards et la proxyfication.
3. Vérifiez les quatre proxyfications, conteneur, librairie gtag, flux serveur, et plateforme de consentement.
4. Activez la restauration de cookies sur `_shopify_y`.
5. Ajoutez le custom : formulaires personnalisés, statut du client, événements propres à votre activité.
6. Mesurez la fiabilité par rapport au back-office, et notez le chiffre.
Ce qu’il faut retenir
– Le tunnel de commande Shopify est isolé depuis 2024. Les fichiers de thème n’y sont plus éditables, le custom pixel est le seul chemin, et les cookies n’y sont plus joints automatiquement aux requêtes.
– Les applications natives valent pour démarrer, et surtout pour la synchronisation du catalogue produit, qu’il faut conserver même après une refonte. Elles coûtent 20 à 25 % du volume de collecte.
– L’architecture visée est hybride, à tous les étages : navigateur et serveur, application native et configuration personnalisée.
– Sans les trois prérequis, proxyfication complète, restauration des cookies via `_shopify_y` et traitement des données personnelles, une configuration server-side ne vaut pas mieux qu’une application native.
– Les résultats se vérifient. 93 % de fiabilité et 22 % de volume gagné sont des ordres de grandeur atteignables, à condition de les mesurer. C’est ce que couvre notre accompagnement tracking e-commerce.
FAQ
Faut-il un compte Shopify Plus pour faire du tracking personnalisé ?
Non. L’édition des fichiers de thème `.liquid` était historiquement réservée aux comptes Shopify Plus, mais elle est ouverte à toutes les formules depuis plusieurs années. En sens inverse, Shopify Plus ne donne aucun accès au tunnel de commande : celui-ci est inéditable pour tout le monde, quelle que soit la formule. Le custom pixel est le seul chemin, pour tous.
Pourquoi mes conversions Shopify ne remontent-elles pas avec le bon canal dans Google Ads ?
C’est le symptôme le plus fréquent depuis le checkout extensibility. Dans le tunnel de commande, les cookies sont bien déposés mais ne sont plus joints automatiquement aux requêtes sortantes. L’achat part donc sans identifiant de clic, et Google Ads ne peut le rattacher à aucune campagne. La correction consiste à lire la valeur du cookie côté client et à la transmettre explicitement en paramètre d’événement.
Le custom pixel Shopify remplace-t-il Google Tag Manager ?
Non, il l’alimente. Le custom pixel est le seul moyen d’écouter ce qui se passe dans le tunnel de commande, mais ce n’est pas un outil de gestion de balises. Il pousse les événements dans votre couche de données, que Google Tag Manager lit ensuite pour les redistribuer. La gouvernance reste dans Google Tag Manager, sans quoi vous vous retrouvez avec une configuration éclatée entre le pixel, les applications natives et le thème.
Combien la collecte perd-elle avec les applications natives seules ?
Environ 20 à 25 % du volume. La majorité des événements transmis par ces applications partent depuis le navigateur, vers des adresses que les listes de filtrage connaissent. S’y ajoute la perte liée à la durée de vie des cookies, ramenée à 7 jours ou 24 heures sur Safari, Firefox et Brave, sans aucun levier possible depuis une application native.
À quoi sert le cookie _shopify_y dans un tracking server-side ?
C’est un cookie déposé nativement par Shopify sur toutes les boutiques, d’une durée de vie de treize mois, qui échappe aux restrictions des navigateurs. Il sert de clé de réconciliation : nous stockons en base de données les cookies analytiques et publicitaires du visiteur indexés par cette clé, et nous les redéposons s’ils ont été supprimés entre deux visites. La durée de vie effective de vos identifiants passe ainsi à environ treize mois.
Faut-il supprimer les applications natives après un passage en server-side ?
Non, et nous recommandons le contraire. Conservez-les pour la synchronisation du catalogue produit vers vos gestionnaires de publicité, un rôle qu’aucun conteneur serveur ne remplit. Sur Klaviyo, nous gardons même l’intégration native en parallèle de la nôtre, pour maximiser la collecte. L’architecture visée est hybride, elle n’est pas pure.
Comment transmettre le consentement aux applications natives de Shopify ?
Par la Customer Privacy API, avec un appel à `setTrackingConsent` portant les catégories analytics, marketing et préférences. Certaines plateformes de consentement le font automatiquement une fois configurées dans Shopify, d’autres non : dans ce cas l’appel se pose à la main, généralement depuis Google Tag Manager. Sans cette transmission, vos applications natives cessent de recevoir des données, ou collectent sans condition, silencieusement dans les deux cas.
Le double envoi vers Meta crée-t-il des conversions en double ?
Non, à condition que les deux envois portent le même identifiant de déduplication. C’est même le déploiement recommandé par Meta : l’événement part côté navigateur, où il peut être bloqué, et en parallèle du serveur vers l’API de conversion, où il ne peut pas l’être. Meta rapproche les deux et ne compte l’achat qu’une fois. Voir deux appels dans l’onglet réseau n’est donc pas un défaut.

Cas clients
Type de business
Type de mission
Sommaire
- 1. Pourquoi le tracking Shopify est-il un cas particulier ?
- a. Qu’est-ce que le checkout extensibility ?
- b. Ce qui ne change pas : tout ce qui se passe hors du tunnel
- c. Ce qui change : tout ce qui se passe dans le tunnel
- d. Le piège des cookies dans le tunnel de commande
- 2. Que valent vraiment les applications natives du Shopify App Store ?
- a. Comment fonctionnent-elles ?
- b. Leurs deux vrais avantages
- c. Limite 1 : aucune personnalisation possible
- d. Limite 2 : la collecte se fait côté navigateur
- e. Limite 3 : les incohérences que vous ne pouvez pas corriger
- f. Limite 4 : le problème de gouvernance
- 3. À quoi ressemble une architecture de tracking Shopify optimale ?
- a. Les trois étages de l’architecture
- b. Un bénéfice rarement mentionné : le site s’allège
- c. Qu’est-ce que le tracking hybride ?
- d. Pourquoi le double envoi n’est-il pas un défaut ?
- e. Faut-il supprimer les applications natives ?
- f. Addingwell et Stape, le socle que nous utilisons
- 4. Quels sont les trois prérequis d’une configuration qui surperforme les applications natives ?
- a. Prérequis 1 : maximiser la collecte
- > Proxyfier le chargement du conteneur
- > Proxyfier la librairie gtag
- > Proxyfier le flux vers le serveur
- > Proxyfier la plateforme de consentement
- b. Prérequis 2 : maximiser la reconnaissance de l’utilisateur dans le temps
- > Pourquoi les cookies meurent-ils si vite ?
- > Qu’est-ce que le cookie _shopify_y ?
- > Comment fonctionne la restauration de cookies ?
- > Pourquoi pas le reverse proxy sur Shopify ?
- c. Prérequis 3 : maximiser l’identification personnelle
- > Reconnaître un visiteur ne passe pas que par les cookies
- > Ce que Shopify récupère par défaut, et ce qu’il manque
- > Ce que nous ajoutons
- 5. Comment gérer le consentement sur Shopify ?
- a. Qu’est-ce que la Customer Privacy API ?
- b. Le problème que nous rencontrons systématiquement
- c. Comment transmettre le consentement ?
- d. Comment vérifier que ça fonctionne ?
- e. Les deux régies à traiter séparément
- 6. Quels résultats pouvons-nous attendre ?
- a. La fiabilité : est-ce que la donnée est juste ?
- b. Le volume : combien de données gagnons-nous ?
- c. La performance : qu’est-ce que ça rapporte ?
- 7. Où en est le marché français ?
- 8. Comment se lancer ?
- 9. Ce qu’il faut retenir
- 10. FAQ
- a. Faut-il un compte Shopify Plus pour faire du tracking personnalisé ?
- b. Pourquoi mes conversions Shopify ne remontent-elles pas avec le bon canal dans Google Ads ?
- c. Le custom pixel Shopify remplace-t-il Google Tag Manager ?
- d. Combien la collecte perd-elle avec les applications natives seules ?
- e. À quoi sert le cookie _shopify_y dans un tracking server-side ?
- f. Faut-il supprimer les applications natives après un passage en server-side ?
- g. Comment transmettre le consentement aux applications natives de Shopify ?
- h. Le double envoi vers Meta crée-t-il des conversions en double ?
Articles Recommandés
Tracking Shopify : formation et guide complet 2026